Behomes
https://behomes.tech/crm-for-real-estate-developers/
Перенос с платформы Bubble на October CMS
Первая версия проекта была реализована на no-code платформе Bubble. Со временем возникли ограничения по производительности, масштабируемости и работе с оплатой за интенсивные API-запросы. В связи с этим была инициирована полная миграция проекта на собственную платформу с использованием PHP, Laravel, October CMS и PostgreSQL, чтобы обеспечить стабильное развитие и масштабирование в будущем.
Работа включала перенос архитектуры, адаптацию данных и парсинг старой структуры под новую платформу. Разрабатывались парсеры и инструменты для корректной миграции данных, с сохранением целостности и функциональности. При этом часть старой логики была переосмыслена под Laravel, что позволило улучшить структуру и производительность, сохранив совместимость с существующими процессами.
Базовый перенос и адаптация заняли примерно 4 месяца. В процессе приходилось учитывать множество модулей и функциональных блоков, согласовывать нагрузку и сроки, а также обеспечивать правильную работу сложных интеграций и зависимостей.
CRM
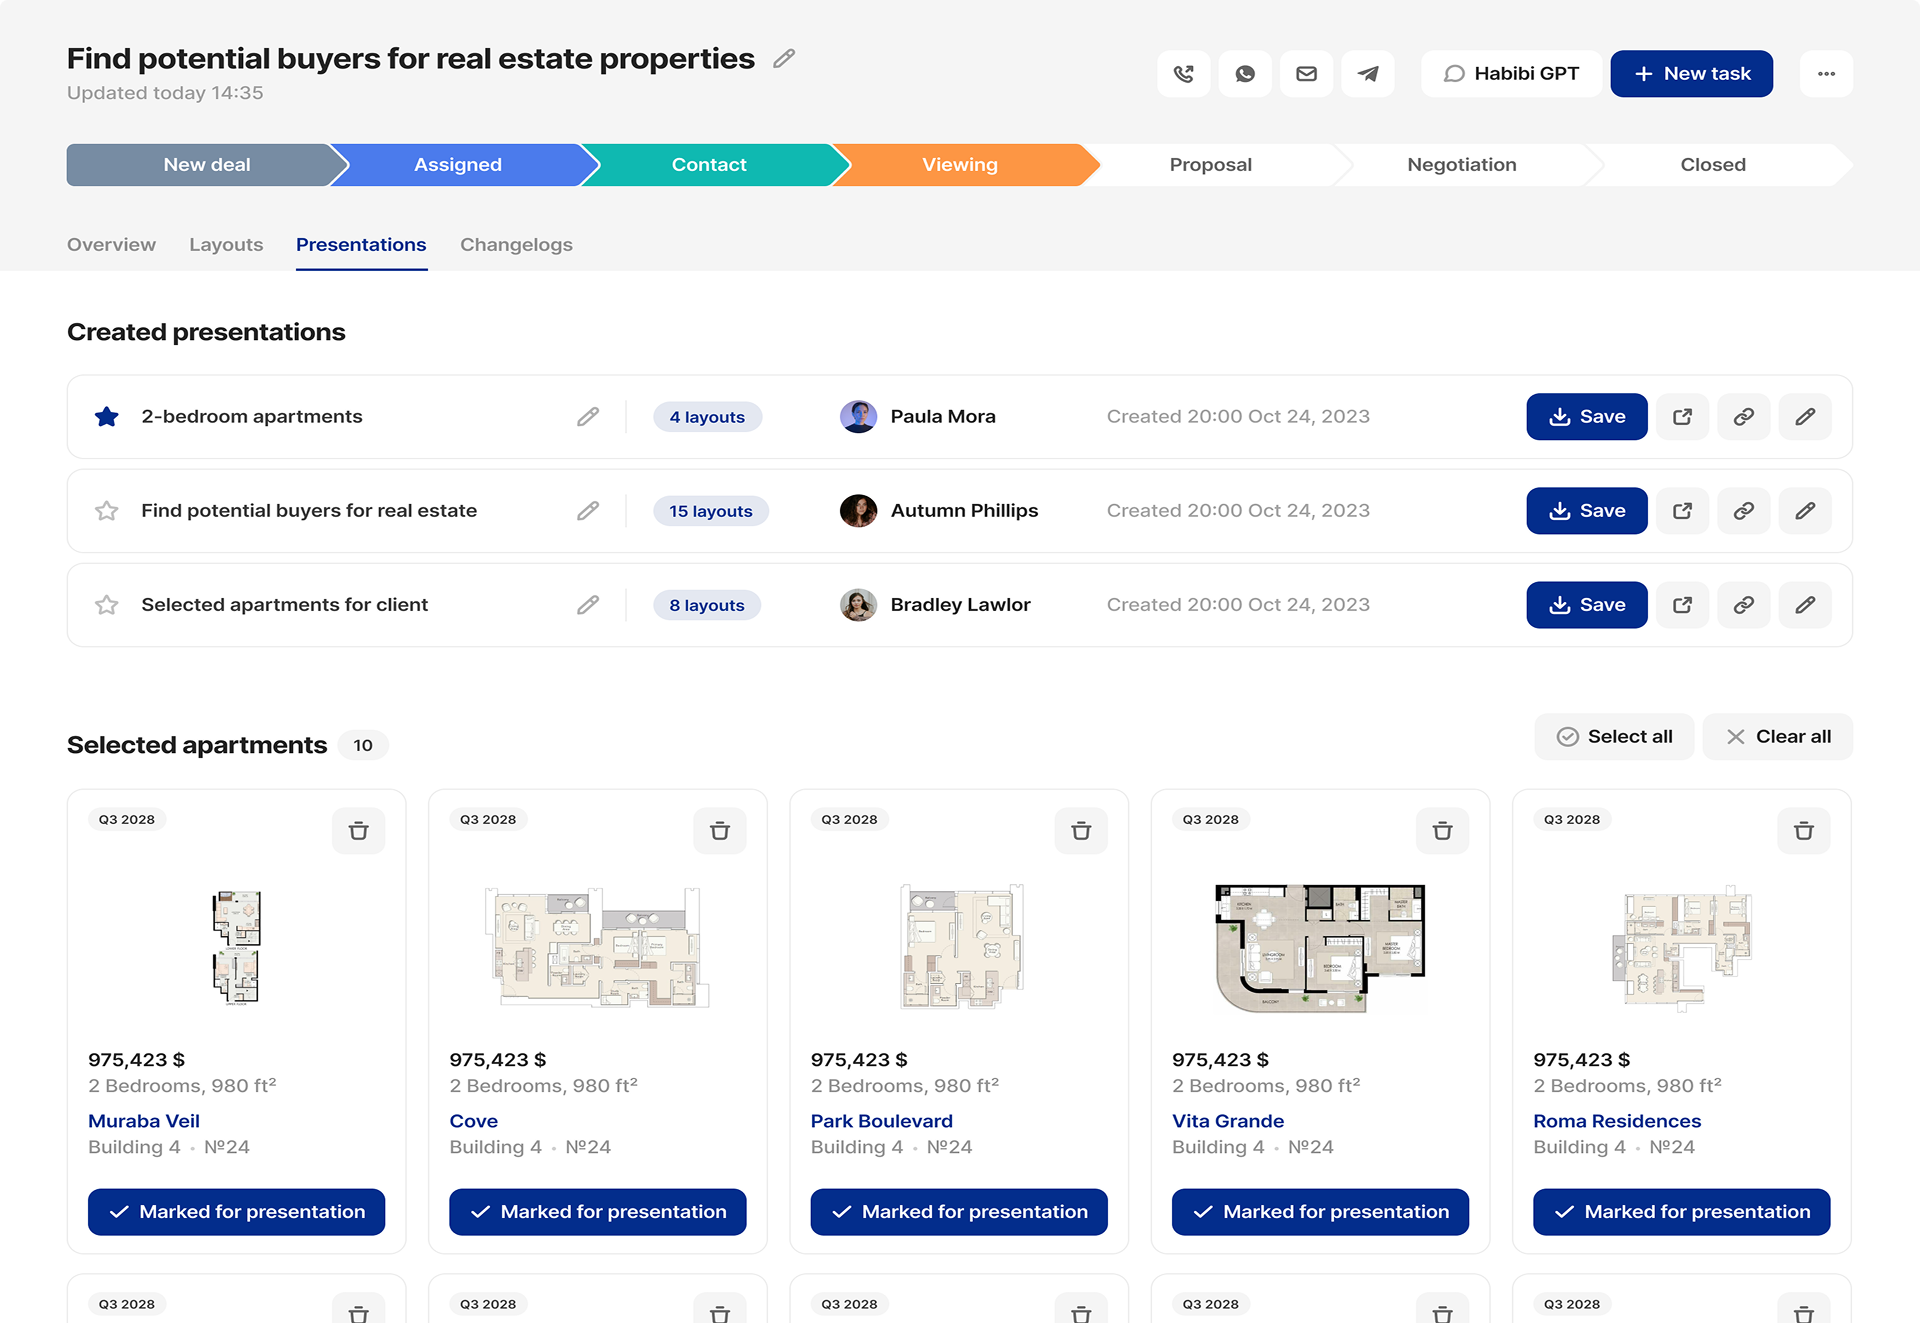
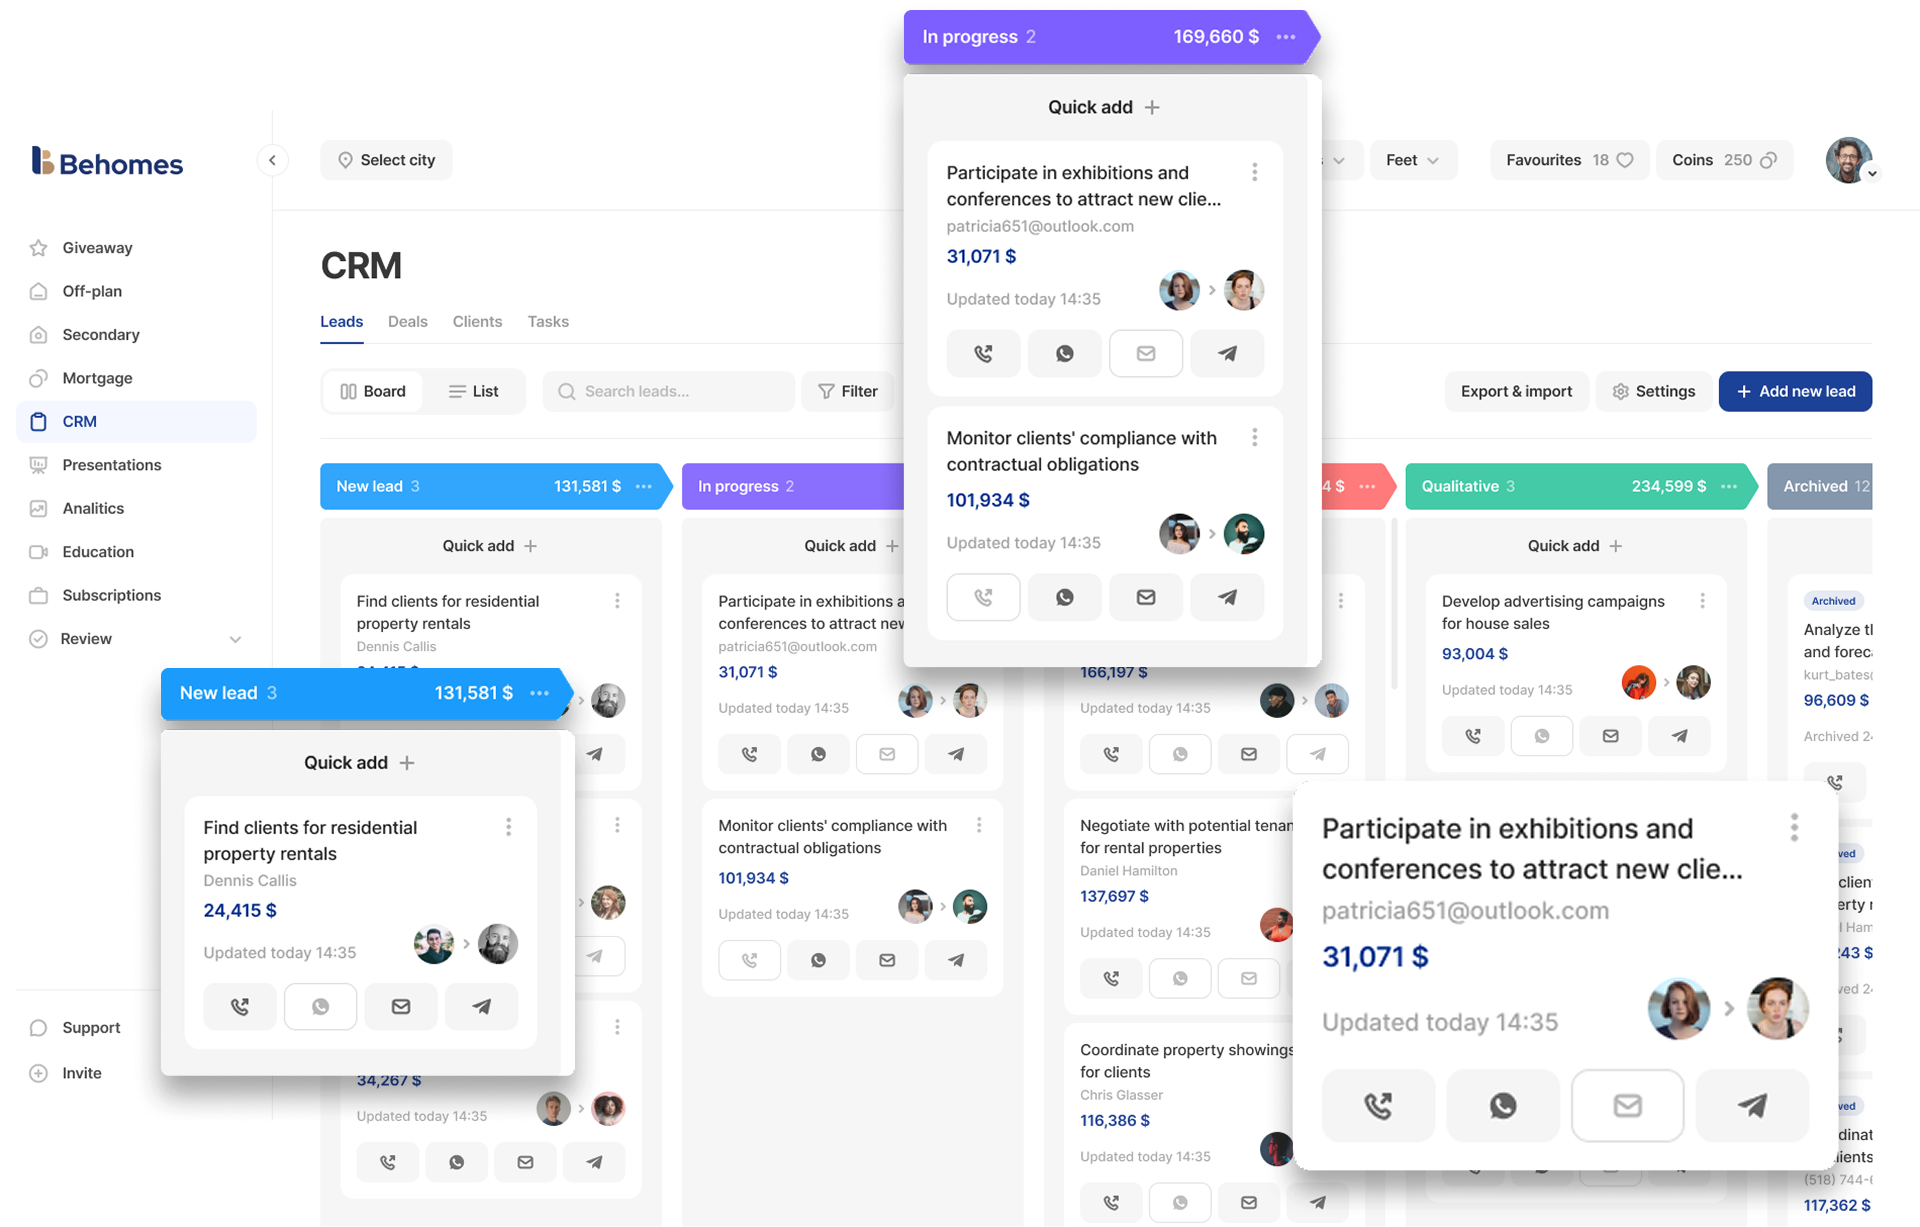
Разработка и расширение внутренней CRM с нуля на базе October CMS и Laravel. Проект стартовал с минимального набора данных из no-code платформы (лиды и базовые контакты), и постепенно развивался в полноценную систему, ориентированную на производительное управление клиентами и сделками.
Структура проекта и направления работы:
- Административная панель — управление менеджерами, систематизация данных, расширение стандартного функционала October CMS через кастомные модули. В ряде случаев разрабатывались нестандартные решения для сложных задач без избыточных костылей.
- Внутреннее API — взаимодействие фронтенда с CRM, обеспечение производительной работы интерфейсов.
- Внешнее API — для партнеров и интеграций (развивалось позже, отличалось от внутреннего API).
Основные сущности: лиды, сделки, задачи, клиенты. Каждая сущность включала множество полей (20–50), справочники и связи. Изначально данные выводились списками с пагинацией и фильтрами, позже добавились канбаны.
Сложность заключалась в производительном отображении больших объемов данных (от 500–1000 записей до 50–70 тысяч), с множеством фильтров, поиском и функциональными обвесами для каждой сущности. В процессе работы проводилось профилирование запросов, оптимизация SQL (джоины, lazy loading, пересмотр запросов для минимального отображения на канбан), настройка индексов и ресурсов сервера.
Этот блок проекта позволил значительно углубить опыт работы с объемными данными, производительной архитектурой, запросами и оптимизацией на уровне backend, а также углубить понимание взаимодействия фронтенда и API.